0%
文章內容僅供參考,不構成任何投資建議,投資前請務必獨立判斷,並自行承擔投資風險及盈虧。


前言:從 Google TPU 看 AI 運算晶片的第二條路
過去 AI 的算力大多由 NVIDIA 主導規格與提供,由於 GPU 的高度通用性,加上 NVIDIA 成熟的 CUDA 軟體生態,使其成為 AI 模型訓練與推論主要的運算平台,AI 算力需求的增加意味著需要採購更多的 GPU 與 NVIDIA 設計好的機櫃。
然而除了 NVIDIA GPU 以外,另一個被大規模部署的 AI 運算平台就是 Google 的 TPU,這之所以值得注意,是因為近期 ASIC 的規模正快速接近 GPU,根據 DIGITIMES 預估, 2027 年高階 AI ASIC 出貨量將超越 GPU 形成黃金交叉,而在各家 CSP 自研晶片中,部署規模最大的即是 Google TPU 。
最早 TPU 是 Google 為自身機器學習需求而開發的專用加速器,如今不只運用在 Gemini,也透過 Google Cloud 對外提供算力,像是 Anthropic 將 TPU 納入其算力基礎設施,這表示 TPU 已不只是 Google 內部使用的專用晶片,而是逐漸發展成可被外部大型 AI 模型公司採用的運算平台,因此以下將分析為何專用 AI 晶片能擴大至今日的部署規模,以及將如何改變未來 AI 算力與半導體供應鏈。
當 AI 運算需求開始分化,晶片架構也隨之分流
隨著不同運算需求間的差異逐漸明顯,訓練(training)模型需要處理大量平行運算,而推論(inference)則重視即時回應、延遲與大量使用者同時存取,隨著不同應用場景逐漸形成,單一晶片架構未必能在所有情境下都展現最佳效率。
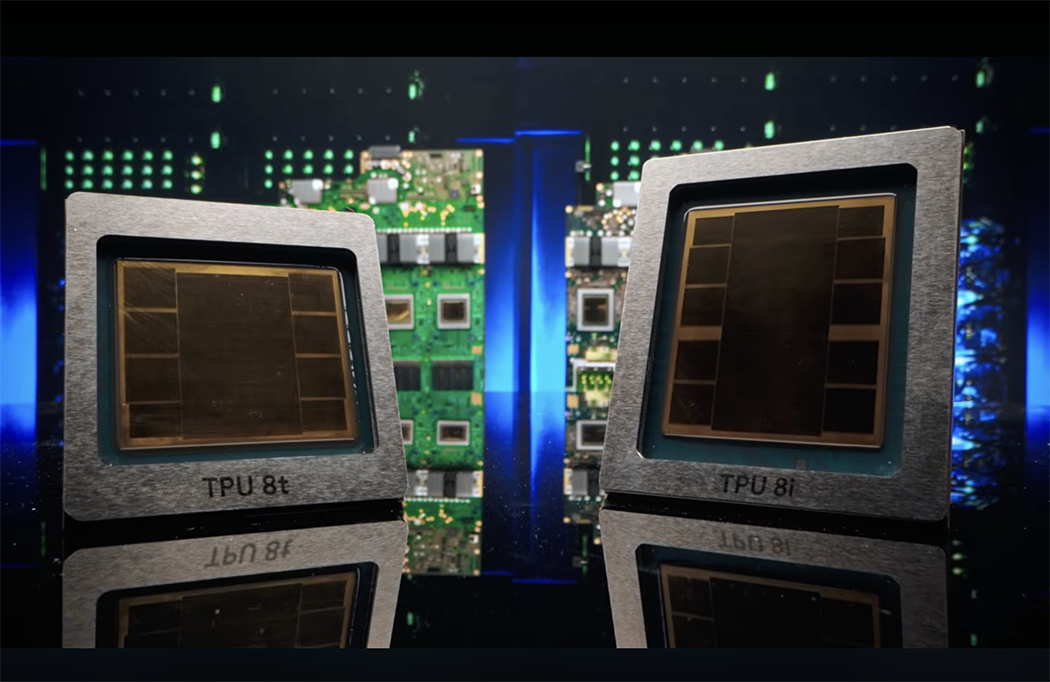
以 Google 第八代 TPU 為例,Google 將其進一步拆分為 TPU 8t 與 TPU 8i,前者主要針對大規模模型訓練,後者則著重推論、後訓練等,背後代表的是隨著 AI 應用規模放大,不同階段對運算、延遲與資料傳輸的需求也開始分化。
Google 第八代 TPU 將訓練(8t)與推論(8i)兩種應用交個不同的 TPU 進行專業分工
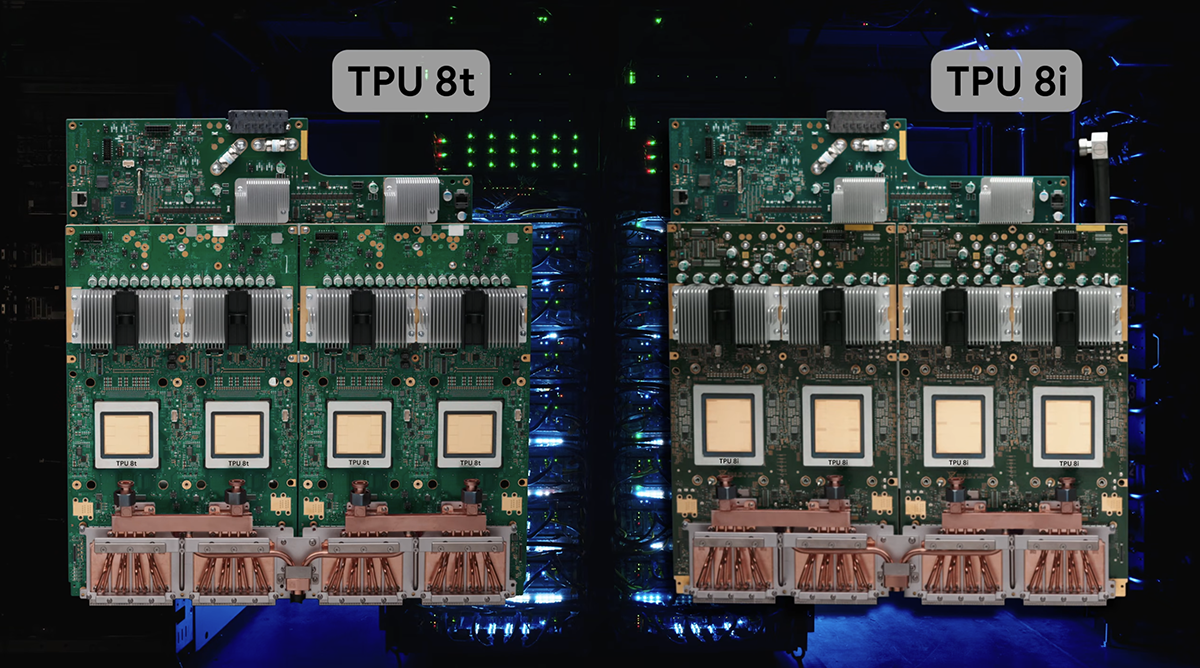
而這正是 ASIC(專用晶片)的優勢,相較於 GPU 的通用性,ASIC 可以針對特定運算需求,在運算單元、記憶體配置、資料傳輸與晶片互連等環節進行更細緻的設計,以提高特定工作負載下的運算與能源使用效率。
CSP 從雲端服務延伸到 AI 算力,也成為 ASIC 的主要推動者
過去雲端的發展,確立了 CSP 作為企業主要的運算基礎設施供應商,企業不需要自行建置完整資料中心,而是依照需求向 AWS、Microsoft Azure、Google Cloud 等平台取得運算、儲存與網路資源。
進入 AI 時代後,這種供應模式基本延續,只是 CSP 提供的運算資源進一步擴展至 GPU 與各類 AI 加速器,除了搜尋與自家 AI 模型等內部需求,同時也服務大量外部客戶,使其掌握規模龐大的 AI 工作負載與運算需求。
這種規模優勢也使大型 CSP 有條件發展自研 ASIC,並將專用晶片從內部開發專案進一步擴大至長期、大規模部署,但這不表示 CSP 會全面以 ASIC 取代 GPU,因為不同工作負載對效能與成本的要求仍然不同,以 Google Cloud 為例,目前便同時提供 NV


